AI의 '데이터 절도', 그 충격적인 내부 고발: 당신이 몰랐던 진실
Published Sep 18, 2026
요즘 AI 챗봇이나 검색 도우미를 사용하지 않는 사람을 찾기 어려울 정도입니다. 궁금한 것을 물어보면 기가 막히게 요약해주고, 복잡한 내용을 쉽게 풀어 설명해주죠. 그런데 혹시 이 편리함 뒤에 보이지 않는 그림자가 드리워져 있다면 어떨까요? 우리가 매일 소비하는 뉴스, 기사, 칼럼 등 수많은 정보들이 사실은 특정 기업의 윤리적 경계를 넘나드는 방식으로 AI 학습에 이용되고 있었다는 충격적인 사실이 드러났습니다. 단순히 “학습 데이터”라고 불리던 것이, 내부적으로는 “인류 역사상 가장 큰 규모의 노동 절도”라고 불릴 정도의 심각한 문제였다는 겁니다. 이는 우리가 AI를 통해 얻는 정보의 신뢰도뿐만 아니라, 콘텐츠를 생산하는 모든 이들의 미래에 엄청난 영향을 미칠 수 있는 폭발적인 뉴스입니다.
내부 고발: “인류 역사상 최대 규모의 절도”
지난 3년간 뉴욕타임스가 오픈AI와 마이크로소프트를 상대로 제기한 저작권 소송에서, 그동안 가려져 있던 충격적인 사실들이 공개되었습니다. 기밀 해제된 법원 문서에 따르면, 마이크로소프트의 고위 임원 중 한 명은 두 회사의 AI 학습 관행을 “절도”라고 사적으로 묘사했습니다. 여기서 그치지 않고, 오픈AI의 리더십 역시 자사의 AI 모델이 학습의 원천이 된 언론사와 기자들에게 “존립 위협(existential threat)“이 될 것이라고 인정한 사실도 밝혀졌습니다. 이 고백들은 그동안 AI 기업들이 주장해온 ‘공정 사용(fair use)’ 원칙에 정면으로 배치되는 내용이라 더욱 주목됩니다.
이 문서들은 AI 기업들이 어떻게 유료 벽(paywall)을 우회하고, 대규모 스크래핑을 통해 학습 데이터셋을 구축했으며, 심지어 데이터에서 저작권 표시를 의도적으로 제거했는지까지 상세하게 기술하고 있습니다. 솔직히 말해서, 이런 내부 고백은 충격적입니다. 공정 사용이라는 방패 뒤에 숨어 실제로는 자신들의 행위를 ‘절도’라고 인지하고 있었다는 것은 윤리적 이중성을 여실히 보여주는 대목입니다. 특히 마이크로소프트의 응용과학 디렉터인 브렌트 헥트(Brent Hecht)는 2023년 1월 내부 메모에서 이를 “전례 없는 규모의 놀라운 절도”, 즉 “인류 역사상 가장 큰 규모의 노동 절도”라고까지 표현했습니다. 상상해보세요. 수많은 기자와 작가가 땀 흘려 만들어낸 콘텐츠가 한 순간에 거대한 AI 시스템의 먹이가 되고, 그 생산자들은 존재론적 위협을 느끼는 상황이라니요.
”파멸의 고리” 그리고 콘텐츠 생태계의 균열
AI 모델 학습에 저작권 자료를 합법적으로 사용할 수 있는지에 대한 답은 여전히 모호합니다. 하지만 법원은 대체로 AI 기업들의 ‘학습을 위한 사용은 공정 사용’이라는 주장에 우호적인 입장을 보여왔습니다. 공정 사용은 패러디, 뉴스 보도, 비평 등 특정 상황에서 허락 없이 저작물을 사용할 수 있도록 허용하는 법적 규칙입니다. 하지만 이번에 공개된 여러 내부 고백은 오픈AI의 공정 사용 방어 논리를 무력화시킵니다. 특히 ‘원작 시장을 대체하거나 해치지 않아야 한다’는 공정 사용의 핵심 요구 사항과 정면으로 충돌하죠.
가장 대표적인 사례가 바로 마이크로소프트의 코파일럿(Copilot) ‘답변 엔진’입니다. 마이크로소프트 자체 데이터에 따르면, 코파일럿은 뉴욕타임스 도메인의 클릭률을 기존 빙(Bing) 검색 대비 무려 93%까지 하락시켰습니다. 브렌트 헥트는 이 현상을 “파멸의 고리(doom loop)“라고 부르며, “이는 우리 모델의 성능과 웹 전체를 동시에 해칠 것”이라고 경고했습니다. AI가 직접 답변을 제공하면서 원본 출처로의 트래픽을 극단적으로 줄여버리는 이 현상은, 콘텐츠 생산자들이 더 이상 수익을 창출하기 어렵게 만들고, 궁극적으로는 양질의 콘텐츠 생산 자체를 위협하게 됩니다.
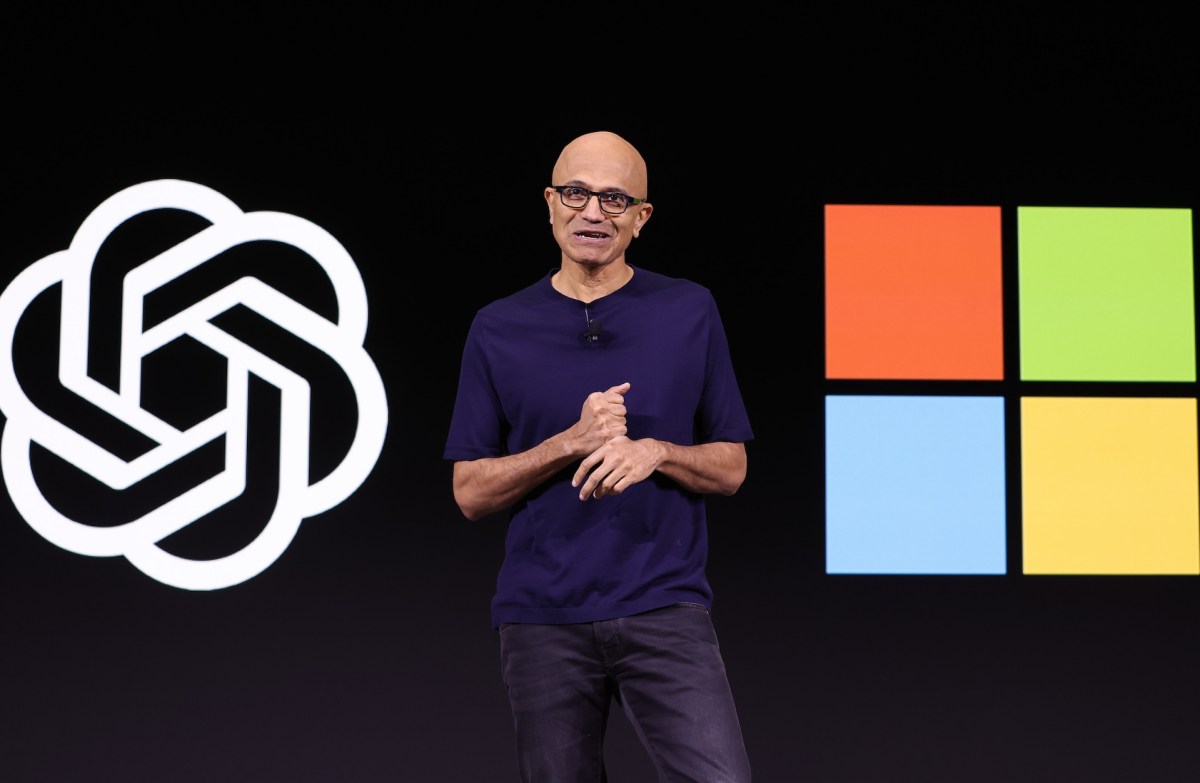
마이크로소프트 CEO 사티아 나델라(Satya Nadella)도 올해 초 진술에서 “유료 벽 뒤에 있는 모든 것은 사용하려는 모든 사람이 라이선스를 받아야 한다”고 증언했습니다. 그는 만약 오픈AI가 유료 콘텐츠를 스크랩하고 학습했다는 사실을 알았다면 모델을 재훈련하도록 요구했을 것이라고 말했습니다. 개인적으로 이 부분에서 주목할 점은, 마이크로소프트의 최고 경영자가 이러한 입장을 표명했음에도 불구하고, 실제로는 그들의 시스템이 콘텐츠 생태계에 치명적인 영향을 미 미치고 있었다는 내부 데이터가 존재했다는 사실입니다. 이는 거대 기술 기업의 이중적인 태도를 보여주는 단면이며, 기술 발전의 혜택과 그 그림자 사이에서 우리가 어떤 균형을 찾아야 할지에 대한 근본적인 질문을 던집니다.
저작권 침해를 넘어선 “의도적 전략”
이번 기밀 해제된 문서들은 오픈AI와 마이크로소프트가 단순히 데이터를 수집한 것을 넘어, 적극적이고 의도적으로 저작권을 침해했다는 정황을 구체적으로 보여줍니다. 예를 들어, 오픈AI의 연구원 닉 라이더(Nick Ryder)가 뉴욕타임스 유료 벽을 우회하는 “해킹 방법”을 브록만(Brockman) 오픈AI 사장에게 말했을 때, 브록만은 “아, 좋다”고 답했습니다. 이는 단순히 시스템의 허점을 이용한 것이 아니라, 콘텐츠 접근을 위한 일종의 ‘전략’이었음을 암시합니다.
또한, 문서들은 오픈AI가 웹텍스트(WebText)와 웹텍스트2(WebText2) 같은 학습 데이터셋을 구축할 때 뉴스 콘텐츠에 불균형적으로 의존했으며, Common Crawl과 같은 공개 웹 크롤 데이터 저장소에서 수백만 개의 기사를 가져왔음을 밝힙니다. 더욱 놀라운 사실은, 연구자들이 모델 출력에서 “저작권 고지”가 나가는 것을 원치 않았기 때문에, 학습 데이터에 포함된 저작권 표시를 의도적으로 제거하려는 노력을 했다는 점입니다. 이 정도라면 단순한 데이터 수집의 문제가 아니라, 고의적인 저작권 침해 및 회피 시도로 해석될 여지가 충분합니다.
오픈AI의 중간 학습 데이터셋만 해도 뉴욕타임스, 데일리 뉴스, 탐사 보도 센터가 발행한 91,692개 이상의 작품 사본을 포함하며, nytimes.com에서만 Common Crawl 기반 데이터셋에 2백만 개 이상의 문서가 포함되었다는 규모는 그야말로 엄청납니다. 뉴욕 데일리 뉴스의 변호사인 스티븐 리버만(Steven Lieberman)은 “여기서 처음 밝혀진 증거들은 오픈AI와 마이크로소프트가 자신들의 행위가 잘못된 것임을 알고 있었다는 것을 보여준다”고 말했습니다.
업계 흐름을 보면, 이러한 폭로들은 AI 개발의 투명성과 윤리적 기준에 대한 요구를 더욱 높일 가능성이 높습니다. 단순히 기술적인 발전만을 추구할 것이 아니라, 그 기술이 사회와 문화, 그리고 인간의 노동에 미치는 영향을 심도 깊게 고려하는 것이 이제는 선택이 아닌 필수가 되어야 할 것입니다. 사실 이건 AI 기술 기업들이 당장 해결해야 할 가장 큰 숙제 중 하나라고 생각합니다. 콘텐츠 생산자들이 존중받고 정당한 대가를 받는 생태계가 유지되지 않는다면, 결국 AI가 학습할 양질의 데이터도 고갈될 수밖에 없지 않을까요?
이번 뉴욕타임스 소송에서 밝혀진 내용들은 AI 시대의 저작권과 콘텐츠 윤리에 대한 논의에 불을 지피는 중요한 전환점이 될 것입니다. 우리는 이 기술이 어디로 나아가야 할지, 그리고 그 과정에서 인간의 창의성과 노동의 가치를 어떻게 지켜나가야 할지에 대해 깊이 고민해야 합니다.
출처
- 원문 제목: Microsoft exec called AI scraping ‘the largest theft of labor in human history,’ new unredacted filings reveal
- 출처: AI News & Artificial Intelligence | TechCrunch
- 원문 기사 보러가기

